On connaît tous la “machine à écrire” des LLM : le texte qui sort mot après mot, de gauche à droite. C’est la génération autorégressive (AR), le paradigme de GPT, Llama, Mistral, Gemma. Google a publié un modèle qui casse ce schéma : DiffusionGemma. Au lieu de produire un token à la fois, il raffine un bloc entier de texte en parallèle, par débruitage itératif - le même principe que la diffusion d’images, mais appliqué au texte.
J’ai voulu comprendre ce qui change réellement dans le modèle, et pas seulement lire “c’est plus rapide”. La bonne nouvelle : le réseau de neurones est quasiment le même. DiffusionGemma reprend le backbone Gemma 4 (mêmes blocs attention + FFN, RoPE, RMSNorm, MoE). Ce qui change tient en trois points : le masque d’attention, l’objectif d’entraînement, et la boucle de décodage. Le reste est identique.
Gardez cette intuition pendant qu’on déroule.
Le modèle classique, passe par passe
Rappel rapide du chemin que suit un token dans un transformer autorégressif.
Embeddings. Les tokens deviennent des vecteurs via une lookup table, mis à l’échelle par √d_model. On obtient une matrice [seq_len, d_model].
N blocs transformers identiques. Chaque bloc enchaîne deux sous-couches.
Attention - on projette x en Q, K, V. Gemma utilise GQA (moins de têtes K/V que de têtes Q, pour alléger le cache). RoPE encode la position par rotation sur Q et K. On calcule les scores Q·Kᵀ / √d_head, et c’est ici qu’intervient le masque de causalité : la matrice triangulaire supérieure est mise à −∞, donc un token ne peut regarder que le passé. Softmax → somme pondérée des V → projection de sortie.
FFN - Gemma utilise GeGLU : (GELU(x·W_gate) ⊙ (x·W_up)) · W_down. Sur un modèle MoE, un routeur sélectionne le top-k experts (chacun un FFN GeGLU) et combine leurs sorties. C’est là que vivent la majorité des paramètres - le “savoir” du modèle.
Chaque sous-couche est encadrée par un résiduel + RMSNorm.
Tête de sortie. RMSNorm final → projection sur le vocabulaire → un vecteur de logits par position.
La boucle autorégressive. On prend les logits de la dernière position, on échantillonne un seul token (temperature/top-p), on l’ajoute à la séquence, et on recommence tout. Le KV cache évite de recalculer les K/V du passé : à chaque pas, on ne calcule qu’une colonne.
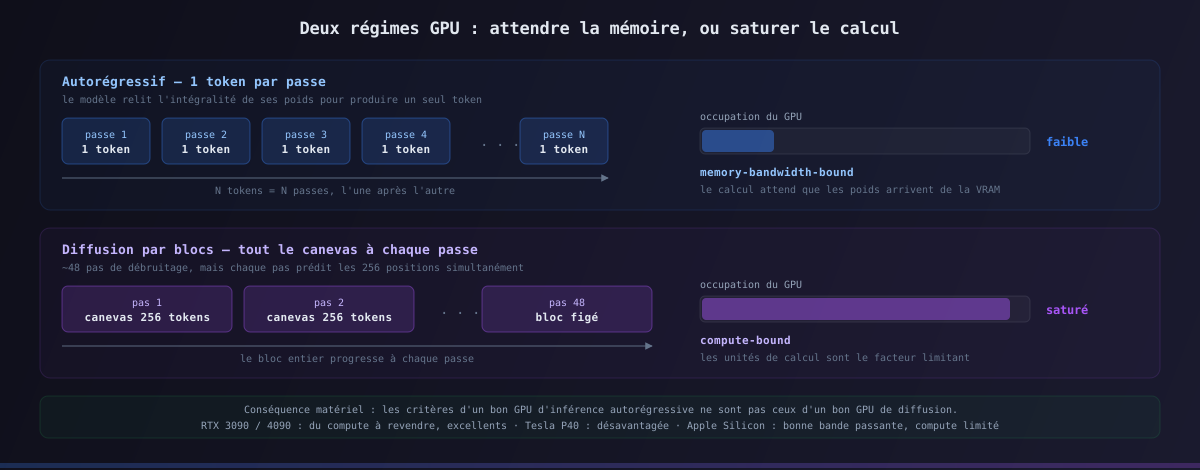
La conséquence cruciale : un pass = un token. Le goulot est memory-bandwidth-bound - à chaque pas, on relit tous les poids + le KV cache juste pour produire un token. Le GPU passe son temps à attendre la mémoire, sous-utilisé en calcul. D’où l’effet “machine à écrire”, et une accélération matérielle limitée en usage mono-utilisateur (batch=1).
La diffusion textuelle, passe par passe
Le problème de fond : le bruit n’est pas continu
Pour les images, le “bruit” est gaussien sur des pixels continus. Le texte, lui, est discret : des IDs de tokens. Impossible d’ajouter simplement du bruit gaussien à un ID.
Une première famille de modèles de diffusion textuelle a contourné le problème avec du masked diffusion : certains tokens sont remplacés par un token [MASK], puis reconstruits. DiffusionGemma ne fait pas ça. Il utilise une Uniform State Diffusion : le bruit consiste à remplacer les tokens par des tokens aléatoires tirés dans le vocabulaire.
Cette différence est importante. Avec un masque classique, une position dévoilée tend à être figée. Avec l’état uniforme, une position peut redevenir du bruit à l’étape suivante si le contexte rend sa prédiction moins crédible. Le modèle peut donc réellement réviser le canevas pendant le débruitage.
La boucle d’inférence
Le modèle part d’un canevas de 256 tokens aléatoires. À chaque pas :
- il prédit une distribution de tokens pour toutes les positions du canevas simultanément ;
- le sampler mesure l’incertitude de ces prédictions ;
- les positions les plus fiables sont conservées ;
- les autres sont re-bruitées avec de nouveaux tokens aléatoires ;
- le modèle recommence sur le canevas entier, jusqu’à stabilisation ou au maximum de pas autorisé.
pas 0   [ x ][ ? ][ q ][ 7 ][ k ][ % ][ z ][ 4 ]   canevas = bruit lexical
           │
           ▼  prédiction parallèle + estimation d'entropie
pas 1   [ Le ][ ? ][ q ][ 7 ][ sur ][ % ][ . ][ 4 ]   les positions sûres émergent
           │
           ▼  les positions incertaines sont re-bruitées
pas 2   [ Le ][chat][ w ][ 9 ][ sur ][ lit ][ . ][ 3 ]
           │
           ▼  raffinement du canevas entier
final   [ Le ][chat][dort][ bien ][ sur ][ le ][ lit ][ . ]
Le sampler recommandé par Google, Entropy-Bounded Denoising, sélectionne les positions de plus faible entropie sous une borne donnée, re-bruite complètement les autres et fait décroître la température de 0,8 à 0,4. Le maximum est de 48 pas, mais l’arrêt adaptatif termine souvent plus tôt quand le canevas est suffisamment stable.
La différence d’attention, le vrai cœur du sujet
L’AR utilise une attention causale : un token ne voit que le passé. La diffusion utilise une attention bidirectionnelle dans le canevas : les 256 tokens étant générés ensemble, chaque position peut “regarder” toutes les autres, y compris celles qui viennent après.
C’est ce qui permet de réviser une position à la lumière de positions ultérieures. C’est particulièrement intéressant pour l’édition in-place, le code infilling et les structures contraintes. Un modèle autorégressif peut évidemment résoudre ce type de problème, mais une fois un token émis il ne peut plus le corriger dans la même passe ; la diffusion, elle, peut revenir sur n’importe quelle position du canevas pendant le débruitage.
L’architecture hybride : block-autoregressive
DiffusionGemma n’est pas full-diffusion, et c’est un point souvent mal compris. Le prompt est traité causalement dans un KV cache, exactement comme en AR. Seul le canevas de 256 tokens est débruité. Une fois le bloc finalisé, il est ajouté au cache, puis on passe au bloc suivant.
┌──────────────────────────────────────────────────────────────────┐
│  PROMPT                                                          │
│  attention causale → KV cache (comme un LLM classique)           │
└────────────────────────────┬─────────────────────────────────────┘
                             │
                             ▼
┌──────────────────────────────────────────────────────────────────┐
│  BLOC 1 - canevas de 256 tokens                                  │
│  attention bidirectionnelle, ~48 pas de débruitage               │
└────────────────────────────┬─────────────────────────────────────┘
                             │ bloc figé → ajouté au KV cache
                             ▼
┌──────────────────────────────────────────────────────────────────┐
│  BLOC 2 - canevas de 256 tokens                                  │
│  ... et ainsi de suite                                           │
└──────────────────────────────────────────────────────────────────┘
Autrement dit : autorégressif entre les blocs, diffusion dans le bloc. On garde l’efficacité du KV cache pour le contexte, et on gagne le parallélisme de la diffusion sur la génération.
Le tradeoff qui compte : compute-bound au lieu de memory-bound
Voici le renversement clé. L’AR est memory-bandwidth-bound. La diffusion, en produisant un bloc entier par passe, est compute-bound : elle sature le calcul du GPU au lieu d’attendre la mémoire.
Conséquence très concrète pour un homelab :
- GPU récents avec beaucoup de capacité de calcul : candidats naturels, puisque la diffusion cherche précisément à utiliser le compute laissé sous-exploité par le décodage AR à faible batch. Unsloth rapporte des débits supérieurs à 2000 tokens/s sur RTX 6000 dans certaines configurations.
- Cartes plus anciennes à faible capacité de calcul : l’avantage peut être nettement plus faible, car le nouveau régime demande davantage de calcul par passe.
- Autres architectures, dont Apple Silicon : impossible de conclure uniquement à partir de la bande passante mémoire. Le bénéfice dépend aussi des kernels disponibles et de la façon dont l’implémentation exploite réellement le matériel.
Le point important n’est donc pas qu’un type de GPU serait universellement “meilleur”, mais que le goulot d’étranglement se déplace. Il faut benchmarker l’implémentation réelle sur le matériel visé.
Le prix à payer : la qualité
Rien n’est gratuit. DiffusionGemma est en dessous de Gemma 4 26B-A4B sur le raisonnement classique, et Google l’assume ouvertement. Le modèle est optimisé pour la vitesse, pas pour être l’état de l’art du raisonnement.
| Benchmark | DiffusionGemma 26B-A4B | Gemma 4 26B-A4B |
|---|---|---|
| MMLU Pro | 77.6 % | 82.6 % |
| AIME 2026 (no tools) | 69.1 % | 88.3 % |
| LiveCodeBench v6 | 69.1 % | 77.1 % |
| GPQA Diamond | 73.2 % | 82.3 % |
Le point fort n’est donc pas le score brut, mais le débit et les cas d’usage qu’ouvre l’attention bidirectionnelle : inférence locale rapide, OCR/parsing de documents, code infilling, workflows agentiques low-latency.
En résumé
| Autorégressif | Diffusion uniforme | |
|---|---|---|
| Génération | 1 token/passe, gauche→droite | bloc de 256 tokens raffiné en parallèle |
| État initial | séquence vide après le prompt | canevas de tokens aléatoires |
| Attention | causale (passé uniquement) | bidirectionnelle (dans le canevas) |
| Régime GPU | memory-bandwidth-bound | compute-bound à faible batch |
| Révision d’un token | impossible une fois émis | oui, pendant le débruitage |
| Idéal pour | qualité de raisonnement | latence locale, infilling, révision de bloc |
Le réseau ne change presque pas : ce sont le masque, l’objectif d’entraînement et la boucle de décodage qui transforment une “machine à écrire” séquentielle en un “débruiteur” parallèle.
DiffusionGemma reste expérimental - quand j’écris ces lignes, le support n’est pas mergé dans le master de llama.cpp, seulement disponible via une PR draft et des GGUF Unsloth - mais c’est un des premiers modèles ouverts qui rend le paradigme concret et testable sur une machine perso.
Ce que vous devez retenir
- La diffusion textuelle ne remplace pas le Transformer : elle change surtout le masque d’attention, l’objectif d’entraînement et la boucle de décodage.
- Le gain potentiel vient du changement de régime matériel : moins de génération séquentielle memory-bound, davantage de calcul parallèle compute-bound.
- DiffusionGemma reste hybride : autorégressif entre les blocs, diffusion bidirectionnelle à l’intérieur d’un bloc de 256 tokens.
- Ne choisissez pas ce paradigme sur la seule promesse de tokens/s : le matériel, les kernels et la baisse de qualité sur certains benchmarks doivent être mesurés ensemble.
Sources :
- DiffusionGemma model overview | Google AI for Developers (doc officielle Google)
- Diffusion in Text Generation Explained | Google AI for Developers (Uniform State Diffusion, attention et multi-canvas)
- google/diffusiongemma-26B-A4B-it | Hugging Face (model card officielle)
- DiffusionGemma - How to Run Locally | Unsloth (benchmarks, 2000+ tokens/s sur RTX 6000)
- DiffusionGemma GGUF | Hugging Face
- llama.cpp PR #24423 - DiffusionGemma (support non mergé dans le master)
- Support GGUF diffusion-gemma | ollama issue #16664