Le goulot d’un LLM en production, ce n’est pas le calcul, c’est la mémoire. À chaque token généré, le modèle relit l’intégralité de ses poids depuis la VRAM pour produire une seule prédiction. Le GPU attend, sous-utilisé. C’est pour ça que la génération est lente : elle est limitée par la mémoire (memory-bound), pas par le calcul (compute-bound).
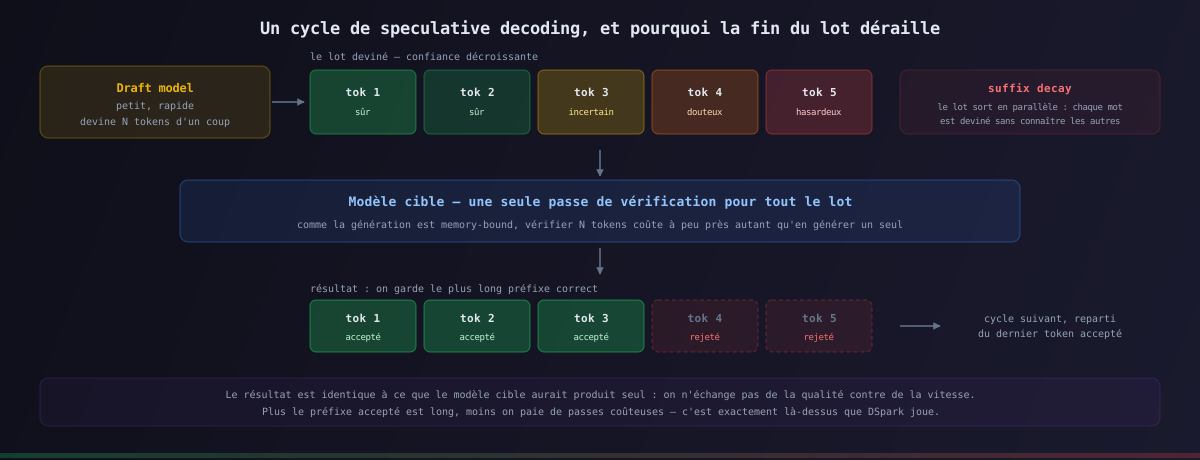
Le speculative decoding attaque ce gaspillage sans toucher au modèle. Un petit draft model propose d’un coup plusieurs tokens futurs, le gros modèle vérifie tout le lot en un seul passage, et on ne garde que la plus longue suite correcte. Le résultat est identique à ce que le gros modèle aurait produit seul : on ne troque pas de la qualité contre de la vitesse.
Pourquoi les prédictions du draft déraillent-elles en fin de lot ? Parce que le draft model prédit tout d’un coup, en parallèle : chaque token est prédit sans savoir ce que seront les autres. Le gros modèle, lui, raisonne dans l’ordre - chaque token qu’il produit dépend du token réellement accepté juste avant. Les premières prédictions du lot s’appuient sur le vrai début et sont souvent justes. Mais plus on avance, plus les prédictions s’appuient sur des prédictions, et plus elles s’écartent de ce que le gros modèle aurait choisi. La fin du lot part en vrille.
DeepSeek a publié en juillet 2026 DSpark dans son repo DeepSpec, avec le code d’entraînement, les checkpoints et le papier. Deux idées propres, chacune répondant à une faiblesse d’une approche existante.
Les deux approches existantes, et leur défaut
Avant DSpark, les draft models tombaient dans deux camps, chacun avec un défaut structurel.
Autorégressifs (EAGLE-3). Chaque mot drafté est généré en fonction du précédent. Précis, mais lent, et les lots prédits restent petits : le gain par cycle est plafonné.
Parallèles (DFlash). Tout le lot sort en une passe. Rapide, lots larges possibles, mais chaque mot drafté ignore les autres : la fin du lot se fait de plus en plus rejeter par le vérificateur. Le papier appelle ça la suffix decay : sur Qwen3, plus on s’éloigne du début du lot, moins les prédictions sont acceptées.
DSpark, idée 1 : relier chaque prédiction à la précédente
DSpark garde la prédiction parallèle de DFlash (tout sort d’un coup), puis ajoute une passe de correction séquentielle (le serial head du papier). Concrètement : une fois le lot drafté en parallèle, un petit module repasse sur les prédictions une par une et ajuste chacune en fonction de la précédente. Le coût de cette passe est minuscule comparé à la prédiction, et ça stabilise la fin du bloc.
C’est ce que le papier appelle la génération semi-autoregressive : un compromis entre le tout-parallèle de DFlash et le strict-ordre-séquentiel d’EAGLE. Plus de mots acceptés par cycle, donc moins de passages coûteux du gros modèle. C’est le titre complet du papier : “Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation”.
Le gain se mesure sur Qwen3-{4B, 8B, 14B} : la longueur de suite acceptée grimpe d’environ 30 % par rapport à EAGLE-3 et de 16 à 18 % par rapport à DFlash.
| Cible | vs EAGLE-3 | vs DFlash |
|---|---|---|
| Qwen3-4B | +30,9 % | +16,3 % |
| Qwen3-8B | +26,7 % | +18,4 % |
| Qwen3-14B | +30,0 % | +18,3 % |
DSpark, idée 2 : économiser la vérification sous charge
La vérification a un coût. Dans le fonctionnement de base, le gros modèle vérifie toutes les prédictions du lot d’un coup, y compris celles de la fin qui seront rejetées. Sur un serveur peu chargé, ça passe. Sur un serveur saturé, ce temps de calcul manque aux requêtes en attente.
DSpark ajoute un module de confiance (le confidence head) : pour chaque prédiction, il prédit la probabilité qu’elle soit acceptée. Un régulateur (le scheduler) surveille la charge du serveur : à charge faible, le gros modèle vérifie tout le lot ; à charge forte, il ne vérifie que le début sûr et passe le reste. Le temps GPU économisé est réalloué aux autres utilisateurs. C’est ce qui transforme le speculative decoding en optimisation au niveau du serveur entier, et pas seulement d’une requête isolée.
Ce que DeepSeek annonce
Le papier évalue DSpark en production sur les moteurs DeepSeek-V4-Flash et V4-Pro, comparé au baseline MTP-1. À débit identique (même throughput) et sans matériel supplémentaire : 60 à 85 % de vitesse en plus par utilisateur sur V4-Flash, 57 à 78 % sur V4-Pro.
Les mesures offline (longueur de bloc acceptée) tournent sur Qwen3 et Gemma, pas sur DeepSeek : les checkpoints publiés couvrent Qwen3-4B/8B/14B et Gemma 4-12B, avec les modèles de référence correspondants. D’où l’hypothèse raisonnable que d’autres labs adoptent l’approche dans leurs stacks.
Sous contrat de service très exigeant (SLA strict), le gain nominal de débit peut monter plus haut (un cas à +661 % est cité), mais les auteurs le présentent explicitement comme non représentatif d’une accélération réelle.
Reproduire ces gains chez soi n’est pas trivial : le draft model doit être 10 à 30x plus rapide que la cible pour que le pari paie. Avec un ratio faible, le speculative decoding peut même être plus lent que le décodage simple. Les 60-85 % sont mesurés sur l’infra de serving de DeepSeek, pas sur du matériel grand public.
Ce que ça donne sur deux RTX 3090
J’ai voulu vérifier ce dernier point chez moi : deux RTX 3090, Qwen3.8-27B en Q3, servi par llama.cpp. Ce modèle embarque sa propre tête MTP, donc le speculative decoding tourne sans rien télécharger de plus. C’est le point de départ, pas la question : la question, c’est ce qu’un vrai draft model apporte par dessus.
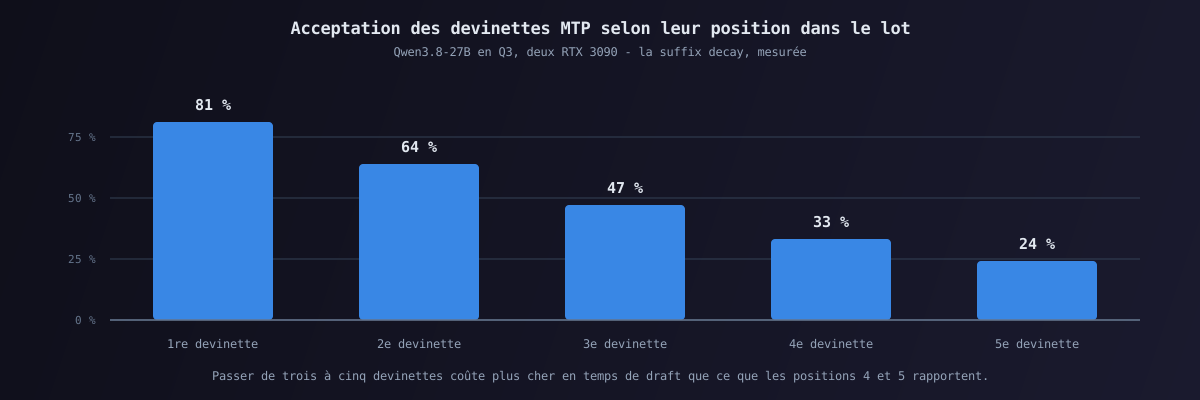
Premier réflexe, augmenter le nombre de prédictions par cycle. La tête MTP de ce modèle est unique, donc chaque position supplémentaire est un passage séquentiel de plus. L’acceptation s’effondre position après position : 81 % sur la première, 64 % sur la deuxième, puis 47, 33 et 24 %. Passer de trois à cinq prédictions fait perdre du débit sur les deux prompts testés. Le plafond n’est pas le nombre de prédictions, c’est la qualité de la tête.
Deuxième essai, le vrai draft model. DFlash 2 publie un drafter entraîné pour cette cible exacte, annoncé à 4,8 tokens acceptés par cycle contre 4,28 pour le MTP natif. Chez moi, il est plus lent que la tête embarquée, sur les deux prompts.
| Configuration | Go, raisonnement, 4000 tokens | Python, sans raisonnement, 600 tokens |
|---|---|---|
| MTP natif, 3 prédictions | 55,6 tok/s | 83,2 tok/s |
| MTP natif, 5 prédictions | 46,4 tok/s | 73,0 tok/s |
| DFlash 2, 7 prédictions | 39,8 tok/s | 69,0 tok/s |
Le drafter n’accepte que 20 % de ses prédictions sur le raisonnement, 46 % sur le code. Ni le décodage glouton ni le passage du prompt en anglais n’y changent grand chose. Mon hypothèse : il a été entraîné et évalué contre une cible en BF16 puis en Q4, et les états cachés d’une cible en Q3 sont trop bruités pour lui. C’est exactement l’avertissement de la fin du papier, vu depuis le garage : les chiffres annoncés valent pour l’infrastructure sur laquelle ils ont été mesurés.
DSpark était mon plan B, avec un drafter converti disponible pour la même cible. Après ce résultat, je ne l’ai pas tenté : le problème n’était pas le choix du draft, c’était la cible quantifiée.
Le gagnant n’est pas un modèle
Le levier qui a payé n’a coûté ni VRAM ni téléchargement. La spéculation n-gram ne prédit rien : elle cherche dans le texte déjà présent une suite identique à celle qu’on vient d’écrire, et propose ce qui suivait. Elle se combine avec le MTP, qui prend le relais quand elle ne trouve rien.
Sur de la génération libre, elle ne sert à rien et ne coûte rien, les deux premières colonnes du tableau ci-dessus bougent à peine. Sur des tâches où le modèle recopie, c’est autre chose.
| Configuration | Réécriture d’un fichier Python de 180 lignes | Édition d’un fichier YAML de configuration |
|---|---|---|
| MTP seul | 57,7 tok/s | 56,9 tok/s |
| n-gram + MTP | 247,6 tok/s | 194,2 tok/s |
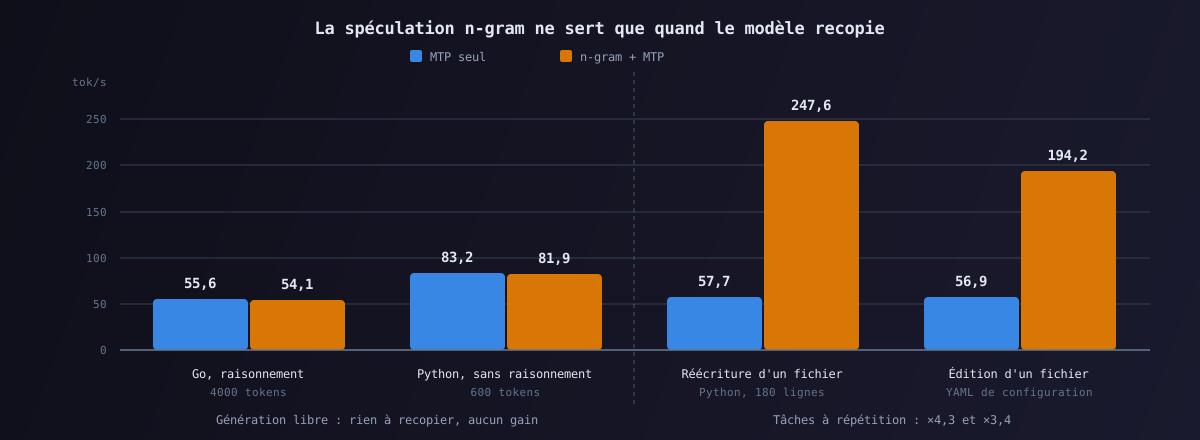
Quatre millisecondes par token sur la réécriture. Le n-gram sert trente-deux tokens d’un coup sur les passages inchangés, le MTP reprend sur ce qui est neuf. Pour un agent de code qui renvoie des fichiers modifiés, c’est le seul des trois essais qui se voit à l’usage.
Le piège que personne ne documente
Un dernier détail, cher en temps perdu. En montant le contexte, le serveur a refusé de démarrer sur un défaut d’allocation de 2 Gio. Ce n’était pas le cache KV du modèle : c’était celui du contexte de draft.
E ggml_backend_cuda_buffer_type_alloc_buffer: allocating 2049.00 MiB on device 1: cudaMalloc failed: out of memory
E common_speculative_init_result: failed to create MTP context
Le contexte spéculatif est créé avec la même taille de contexte que la cible, et alloue donc son propre cache, proportionnel au contexte, posé en entier sur une seule carte. Environ 1,7 Gio à 262 144 tokens. Aucun calculateur de VRAM ne compte ce terme, et il tombe sur la carte que le tensor split a déjà le plus chargée.
En résumé
| Autorégressif (EAGLE-3) | Parallèle (DFlash) | DSpark | |
|---|---|---|---|
| Prédictions | une par une | tout le lot d’un coup | tout le lot + passe de correction |
| Défaut | lente, lots courts | fin du lot rejetée | - |
| Vérification | - | - | sélective (module de confiance) |
Le réseau du gros modèle ne bouge pas. Ce sont le draft model et le régulateur qui changent : des prédictions reliées entre elles pour en faire accepter plus, une vérification sélective pour ne plus gaspiller de GPU sous charge.
Ce que vous devez retenir
- Un meilleur draft model ne garantit pas un meilleur débit : il doit être suffisamment rapide et suffisamment aligné avec la cible pour amortir son coût.
- La quantization de la cible peut dégrader fortement l’acceptation d’un drafter entraîné dans une autre configuration.
- Sur les tâches de réécriture, la spéculation n-gram peut être beaucoup plus efficace parce qu’elle réutilise directement les séquences déjà présentes.
- Le contexte spéculatif consomme lui aussi de la VRAM : dimensionner seulement le modèle principal et son KV cache sous-estime la mémoire réelle.
Sources
- Repo officiel : deepseek-ai/DeepSpec (MIT)
- Papier : DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
- Checkpoints :
deepseek-ai/dspark_qwen3_4b_block7,..._qwen3_8b_block7,..._qwen3_14b_block7,..._gemma4_12b_block7 - Note : attention aux articles tiers qui reprennent le sujet (ex. deepseek.ai, non affilié à DeepSeek) - se baser sur le repo officiel et le papier.