Vous envoyez une image à un LLM et lui demandez ce qu’il voit. Intuitivement, on imagine le modèle qui “regarde” l’image, comme nous. Mais ce n’est pas comme ça que ça marche. Pendant longtemps, pour donner des yeux à un modèle de langage, on lui a simplement collé un autre réseau de neurones devant : un encodeur de vision qui analyse l’image et transmet au LLM une représentation qu’il peut comprendre. Un “traducteur” entre les pixels et le langage.
Google DeepMind a publié en juin 2026 un modèle qui casse ce schéma : Gemma 4 12B. Une architecture “encoder-free” où les images et l’audio entrent directement dans le Transformer, sans encodeur dédié. Quantifié, le modèle annonce environ 6,6 Go de VRAM (quantification Q4_K_M), assez pour tourner sur un laptop. J’ai voulu comprendre comment c’est possible, ce que ça coûte, et ce que ça change concrètement pour un homelab.
Le modèle classique : une petite équipe de spécialistes
Un LLM n’est qu’un modèle de langage : il reçoit des tokens, des morceaux de texte convertis en nombres. Écrivez “il y a un chat sur la table”, aucun problème. Donnez-lui directement la photo d’un chat, c’est un autre monde : une image, ce sont des pixels, et le modèle n’a aucune idée de ce qu’il doit en faire.
La solution historique consiste à placer un autre réseau devant lui :
- Un vision transformer analyse l’image et extrait des caractéristiques utiles.
- Un adaptateur convertit ces informations dans le format du modèle de langage.
- Pour l’audio, un encodeur audio spécialisé traite le signal sonore avant de le transmettre.
Concrètement, votre IA ressemble à une petite équipe de réseaux connectés les uns aux autres. Ça marche très bien - mais chaque encodeur :
- ajoute des paramètres (le gros encodeur visuel ~550M, l’audio plusieurs centaines de M) ;
- fait sa propre passe forward, donc cumule de la latence et de la mémoire ;
- est souvent figé à l’entraînement, donc impossible à affiner de bout en bout avec le reste.
Tout ce poids se paie en VRAM. C’est la limite qui a longtemps rendu la multimodalité incompatible avec le local.
Gemma 4 12B : supprimer les encodeurs
Gemma 4 12B (11,95 Md paramètres, sorti le 3 juin 2026, licence Apache 2.0) remplace cette équipe par un seul Transformer decoder-only censé tout apprendre lui-même. Trois composants remplacent les encodeurs :
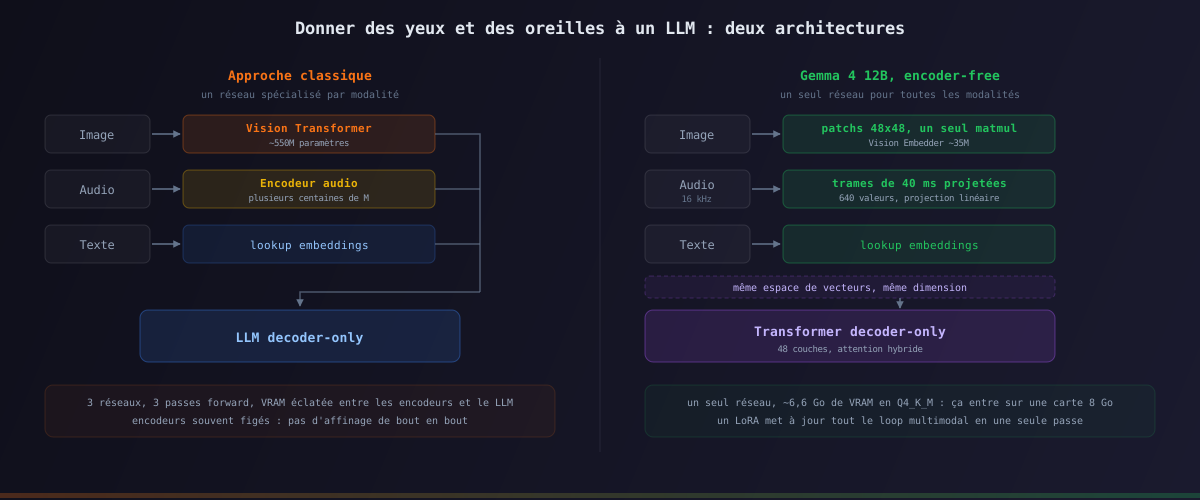
Vision Embedder (~35M paramètres). Fini le gros réseau de vision. L’image est découpée en patchs de 48×48 pixels, projetés vers la dimension cachée du LLM par une seule multiplication matricielle. Un lookup de coordonnées factorisé (matrices X et Y) attache la position spatiale de chaque patch. Pas de backbone ViT, pas d’extraction multi-couches : un matmul.
Audio Wave Projection. L’encodeur audio saute, y compris les 12 couches conformer des modèles edge Gemma 4 E2B/E4B. Le signal brut est échantillonné à 16 kHz (16 000 valeurs par seconde) et découpé en trames de 40 ms, soit 640 valeurs chacune. Chaque trame est projetée en un seul vecteur par une multiplication matricielle linéaire, dans le même espace que les embeddings de texte.
Concrètement, le LLM ne reçoit pas de son : il reçoit des vecteurs. Pour le texte, chaque token devient un vecteur via la lookup table d’embeddings. Pour l’audio, chaque trame devient un vecteur via sa projection. Les deux ont la même dimension et s’insèrent dans la même séquence que le Transformer traite. Vue de l’intérieur, une trame audio n’est qu’un vecteur de plus dans la séquence - le réseau ne distingue pas s’il vient d’un mot ou d’un morceau de son. C’est ça, “entendre” pour un LLM : lire des vecteurs.
Le même Transformer pour tout le reste. Texte, image et audio arrivent dans le même réseau, qui doit apprendre les relations entre eux. Si on lui montre assez de photos de chiens associées au concept “chien”, il apprend que certaines configurations de pixels correspondent à ce concept - et c’est le même principe pour la parole.
La frontière entre perception et raisonnement devient floue : ce n’est plus “un réseau voit, un autre écoute, le LLM raisonne sur ce qu’on lui transmet”. Le cerveau devient aussi les yeux et les oreilles.
L’attention hybride qui rend le 256K possible
Gemma 4 12B fait 48 couches avec une attention hybride : la plupart utilisent une fenêtre glissante de 1024 tokens (locale, bon marché), intercalées de couches d’attention globale qui voient tout le contexte. Ce mélange permet de tenir une fenêtre de 256K tokens sans faire fondre le GPU. C’est aussi le principe qui rend le modèle praticable en local malgré une grande capacité de contexte.
Les benchmarks : un 12B qui bat le 27B de la génération d’avant
Les chiffres ci-dessous sont les valeurs officielles des modèles instruction-tuned (-it), publiées par Google.
| Benchmark | Gemma 4 12B | Gemma 3 27B (réf) |
|---|---|---|
| MMLU Pro | 77,2 % | 67,6 % |
| GPQA Diamond | 78,8 % | - |
| AIME 2026 (no tools) | 77,5 % | - |
| LiveCodeBench v6 | 72,0 % | - |
| Codeforces ELO | 1659 | - |
| MMMU Pro | 69,1 % | - |
Un 12B qui surclasse le flagship 27B de l’année précédente sur MMLU Pro, à moins de la moitié de la VRAM : c’est le genre de saut générationnel qui fait vérifier deux fois ses calculs de matériel.
Côté vision et raisonnement exhaustif, les gains sur les tâches dures sont encore plus marqués. Sur BBEH (suite large de raisonnement), le 12B grimpe à 53 contre ~18 pour Gemma 3 27B. Sur DocVQA et InfoVQA (questions-réponses sur documents), il talonne le 26B (88,4 en InfoVQA), bien au-dessus de Gemma 3 27B. Le design encoder-free paie visiblement sur la compréhension documentaire, où l’encodage spatial des tokens compte.
Deux réserves. Les tirets signifient que Google n’a pas publié de Gemma 3 27B sur ces lignes. Et ces scores sont ceux des versions instruction-tuned - les modèles base diffèrent.
Ce que ça change pour le homelab
En supprimant les encodeurs lourds, plus de VRAM est disponible pour le raisonnement lui-même. Concrètement :
- ~6,6 Go de VRAM en Q4_K_M → ça entre sur une 8 Go.
- 16 Go de VRAM ou mémoire unifiée → confortable (macOS M-series OK).
- Un laptop 16 Go suffit pour faire tourner des workflows agentiques.
| Quantization | VRAM approx. | Usage |
|---|---|---|
| Q4_K_M | ~6,6 Go | défaut raisonnable, entre sur 8 Go |
| Q5_K_M | ~8,5 Go | un peu plus de précision |
| Q8 | ~13 Go | quasi qualité pleine, cartes 16 Go+ |
| QAT Q4_0 | ~6,6 Go | meilleur rapport qualité/Go (sorti 5 juin) |
La commande la plus courte :
ollama run gemma4:12b # 7,6 Go de téléchargement
Le paquet Ollama pèse plus que les ~6,6 Go annoncés pour la VRAM : les chiffres varient selon le format et ce qui est embarqué. Ce sont les valeurs publiées, je ne les ai pas mesurées.
Ou via llama.cpp / GGUF, et pour l’API OpenAI-compatible, LiteRT-LM sert le modèle localement avec cache de préfixe pour masquer la latence de prefill.
Un exemple concret, en local
Un cas d’usage typique : analyser une capture d’écran d’un dashboard Grafana et faire résumer les alertes critiques. L’image ne quitte jamais la machine, rien ne part dans le cloud.
# API Ollama locale, l'image part en base64, tout reste sur la machine
curl http://localhost:11434/api/chat -d '{
  "model": "gemma4:12b",
  "messages": [{
    "role": "user",
    "content": "Résume cette capture : quelles alertes sont critiques ?",
    "images": ["<screenshot en base64>"]
  }]
}'
Pas d’encodeur vision séparé : les patchs 48x48 de la capture entrent directement dans le Transformer, comme des tokens de texte. Le même réseau qui lit votre question lit les pixels de l’image. Un seul passage, un seul espace de représentation.
Pourquoi c’est intéressant pour les agents
Au-delà d’économiser quelques centaines de millions de paramètres, c’est la philosophie qui compte : une architecture unifiée, où un seul Transformer lit du texte, regarde une interface, comprend une image et de l’audio, puis agit. C’est exactement le profil d’un agent local. Google l’a d’ailleurs testé en conditions réelles : sur un extrait d’un peu plus de cinq minutes du keynote Google I/O, le modèle a traité 313 frames à 1 FPS avec l’audio correspondant, puis répondu à des questions sur ce qui s’était passé.
Et ça simplifie le fine-tuning : plus d’encodeur figé à préserver. Un LoRA ou un full fine-tune met à jour tout le loop multimodal en une seule passe, au lieu de devoir co-entraîner des encodeurs séparés avec des gradients potentiellement incompatibles.
En résumé
| Classique | Gemma 4 12B | |
|---|---|---|
| Image | encodeur vision lourd (~550M) | embedder vision ~35M, patchs 48×48 projetés |
| Audio | encodeur audio (centaines de M) | trames 40 ms projetées linéairement |
| Architecture | équipe de spécialistes connectés | un seul Transformer decoder-only |
| VRAM | éclatée entre encodeurs + LLM | ~6,6 Go Q4, laptop 16 Go |
| Fine-tuning | encodeurs figés séparés | tout le loop en une passe |
Gardez l’intuition finale : un seul cerveau, à qui on donne du texte, des pixels et du son, et qui apprend à les comprendre lui-même. L’encodeur-free n’est pas (encore) la norme - les architectures classiques ont toujours d’énormes avantages sur les détails complexes. Mais Gemma 4 12B montre qu’on peut prendre un seul cerveau, lui donner les matières brutes, et le laisser se débrouiller - dans une taille qui tient sur une carte grand public. C’est un vrai pas vers des modèles locaux véritablement multimodaux.
Ce que vous devez retenir
- Encoder-free ne veut pas dire “sans représentation” : image et audio sont toujours projetés en vecteurs, mais sans gros encodeur spécialisé en amont.
- L’intérêt principal est l’unification : le même Transformer traite texte, image et audio, ce qui simplifie l’architecture et le fine-tuning.
- Pour le local, le gain pratique est la VRAM libérée par les encodeurs séparés : un modèle multimodal devient envisageable sur du matériel grand public.
- Gardez néanmoins les architectures à encodeurs spécialisés en tête lorsque la perception fine compte davantage que la simplicité du système.
Sources :
- Nerdy Kings - “Gemma 4 change complètement la vision des IA” (vidéo à l’origine de l’article)
- Introducing Gemma 4 12B: a unified, encoder-free multimodal model | Google (3 juin 2026)
- Gemma 4 Technical Report | arXiv (benchmarks officiels)
- Gemma 4 12B: Benchmarks, VRAM & How to Run It | TECHSY (benchmarks MMLU Pro, VRAM par quantization, attention hybride)
- Gemma 4 12B: Run Locally, Fine-Tune, Benchmark | Labellerr (détail Vision Embedder / Audio Wave Projection / BBEH / DocVQA)
- Google DeepMind Releases Gemma 4 12B | MarkTechPost (4 juin 2026)