J’ai commencé avec le stack “sérieux” : KServe + vLLM. J’ai fini avec un binaire C++ et un fichier GGUF. Et c’est mieux comme ça.
Le contexte
Cluster RKE2, une RTX 3090 (24 GB VRAM), ArgoCD pour le GitOps. L’objectif est simple : un endpoint OpenAI-compatible pour du coding et du chat.
Pourquoi j’ai commencé par vLLM
J’ai choisi vLLM pour une raison précise : le continuous batching. Sous charge, un serveur qui sert plein d’utilisateurs en même temps gagne énormément à regrouper les requêtes : au lieu de produire un token pour une requête à la fois, il mélange les tokens de toutes les requêtes en cours dans un même passage. C’est la feature reine des serveurs d’inférence modernes, et vLLM la fait très bien.
La réalité : je suis tout seul
Sauf qu’il n’y a pas plein d’utilisateurs. Il y a moi, et quelques agents (Claude Code, des scripts). Même avec plusieurs agents en parallèle, on reste sur quelques requêtes concurrentes. Le continuous batching brille à l’échelle de dizaines ou centaines d’utilisateurs ; à 2-5 sessions simultanées, il n’apporte quasi rien.
C’est ça, la vraie raison de la migration : je payais toute la complexité de vLLM (et de KServe autour) pour une feature dont je n’avais pas besoin. llama.cpp fait le job sans cette couche - plus simple à déployer, plus simple à paramétrer, et je peux démarrer un pod avec plusieurs conteneurs dedans.
Ce qui n’allait pas avec vLLM
Trop de couches
KServe tire avec lui Knative, un service mesh, des CRDs, des webhooks d’admission. Le chemin d’une requête :
KServe Controller -> Knative Serving -> Istio -> InferenceService -> vLLM
Quand ça casse quelque part dans la chaîne, le debug est pénible. Pour un seul modèle sur une seule GPU, c’est disproportionné.
Le cold start
Deux à trois minutes pour démarrer. Le runtime Python, PyTorch, le chargement des weights… Sur un homelab, c’est long.
Les modèles quantizés
vLLM gère GPTQ et AWQ. Le support GGUF est arrivé tard. Or avec 24 GB de VRAM, la quantization est obligatoire au-delà de 13B paramètres. Je me suis retrouvé limité sur le choix des formats et des modèles.
La RAM
2 à 4 GB de RAM système consommés avant même de charger un modèle. Le runtime Python et les dépendances PyTorch pèsent lourd.
llama.cpp : le retour à la simplicité
Le stack complet :
ArgoCD -> Helm Chart -> Deployment -> llama.cpp server
Un Deployment Kubernetes standard. Pas de CRDs, pas de service mesh, pas d’opérateur.
Le format GGUF est natif, les quantizations sont finement calibrées (Q4_K_M, Q5_K_M, Q6_K…), et la communauté publie des versions optimisées pour chaque nouveau modèle dans les heures qui suivent.
Cold start avec le modèle déjà en cache sur un PVC : 15 secondes.
L’API /v1/chat/completions est exposée nativement. Drop-in replacement pour tout client OpenAI.
Un pod, plusieurs modèles
La simplicité de llama.cpp a un autre avantage : chaque modèle peut tourner dans son propre conteneur, dans le même pod. J’y fais cohabiter un LLM de coding, un OCR, un reranker et un embedder - chacun avec sa config (port, tensor split, taille de contexte), les GPU partagés entre eux.
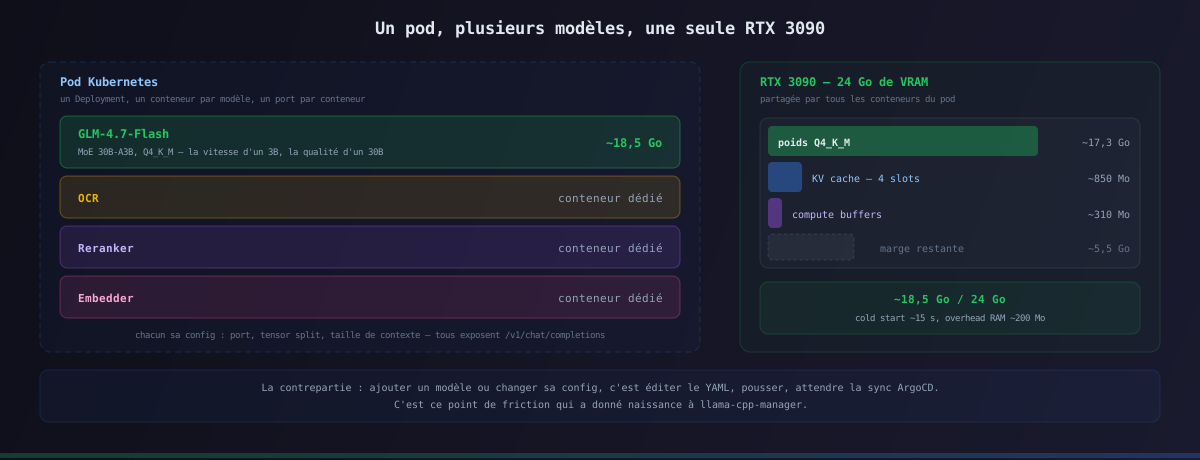
La contrepartie, c’est la gestion : ajouter un modèle ou changer sa config, c’est éditer le YAML, pousser, attendre la sync ArgoCD. C’est devenu le point de friction - et c’est la genèse de llama-cpp-manager, une UI pour piloter tout ça depuis le cluster.
GLM-4.7-Flash : le bon modèle au bon moment
GLM-4.7-Flash est un Mixture-of-Experts 30B-A3B. 30B de paramètres au total, mais seulement 3B activés par token. Concrètement :
- La vitesse d’un modèle 3B
- La qualité d’un modèle 30B
- 18 GB de VRAM en Q4_K_M
Sur une 3090, ça rentre avec de la marge pour le KV cache.
Modèle Q4_K_M :    ~17.3 GB
KV cache (4 slots): ~850 MB
Compute buffers :   ~310 MB
Total :             ~18.5 GB / 24 GB
Un modèle dense de taille comparable (Qwen-2.5-32B) pèserait 20 GB et activerait 32B de paramètres à chaque token. Plus lent, plus gourmand, moins de marge.
Le speculative decoding sans draft model
Le problème de la génération autoregressive : un token à la fois, séquentiellement. La GPU attend entre chaque step.
La solution classique est le speculative decoding avec un petit modèle “draft” qui devine les prochains tokens, et le gros modèle qui valide en batch. Mais ça demande un second modèle compatible (même tokenizer), et de la VRAM supplémentaire.
Pour GLM-4.7-Flash, il n’existe pas de draft model adapté. Le vocabulaire de 154K tokens est spécifique à la famille GLM.
Les n-grams à la rescousse
llama.cpp propose du speculative decoding sans modèle externe, basé sur les n-grams :
--draft 8 --spec-type ngram-simple
Le serveur maintient un cache des séquences de tokens déjà générées dans la session. Quand il rencontre un pattern qu’il a vu, il propose la suite comme draft. Le modèle valide le batch en un seul forward pass.
Ça marche bien pour :
- Le code : imports, error handling, boilerplate - beaucoup de répétitions
- Le JSON/YAML : structures récurrentes
- Les conversations longues : le cache s’enrichit au fil des échanges
Le coût : ~16 MB de RAM. Zéro VRAM supplémentaire.
La limite : ça ne prédit rien sur du texte nouveau. L’efficacité augmente avec la longueur de la session.
Le setup Kubernetes
image: ghcr.io/ggml-org/llama.cpp:server-cuda

args:
  --model /models/GLM-4.7-Flash-Q4_K_M.gguf
  --n-gpu-layers 99
  --ctx-size 16384
  --parallel 4
  --jinja
  --draft 8
  --spec-type ngram-simple
Un init container télécharge le GGUF depuis HuggingFace si le fichier n’est pas déjà sur le PVC. Au redémarrage suivant, il skip.
Le tout déployé via un Helm chart maison, piloté par une ArgoCD Application. Le modèle change ? J’édite le YAML, je push, ArgoCD sync.
Ce qu’on y a gagné
| vLLM + KServe | llama.cpp | |
|---|---|---|
| Stack | KServe + Knative + CRDs | Un Deployment |
| Format | safetensors | GGUF |
| Cold start | 2-3 min | ~15 sec |
| RAM overhead | 2-4 GB | ~200 MB |
| Quantization | GPTQ/AWQ | Q2 à Q8 |
| Spec. decoding | Draft model requis | N-gram intégré |
Pour du multi-GPU en production avec de l’auto-scaling, vLLM reste pertinent. Pour une seule GPU dans un homelab, llama.cpp est plus adapté.
Ce que vous devez retenir
- Pour servir un seul GPU dans un homelab, la simplicité opérationnelle de llama.cpp peut peser davantage que les fonctions avancées de vLLM.
- GGUF et les quantizations permettent de garder assez de VRAM pour le modèle, le KV cache et plusieurs slots sans multiplier les composants.
- Le speculative decoding par n-gram coûte presque rien et devient surtout intéressant sur le code, le JSON/YAML et les longues sessions répétitives.
- vLLM reste pertinent pour le multi-GPU et l’autoscaling : le bon choix dépend du profil de serving, pas d’un classement absolu.
Sources
- GLM-4.7-Flash | Hugging Face (30B-A3B MoE, benchmarks, vocabulaire 154K)
- llama.cpp | GitHub (n-gram speculative decoding, formats GGUF)
- vLLM | GitHub