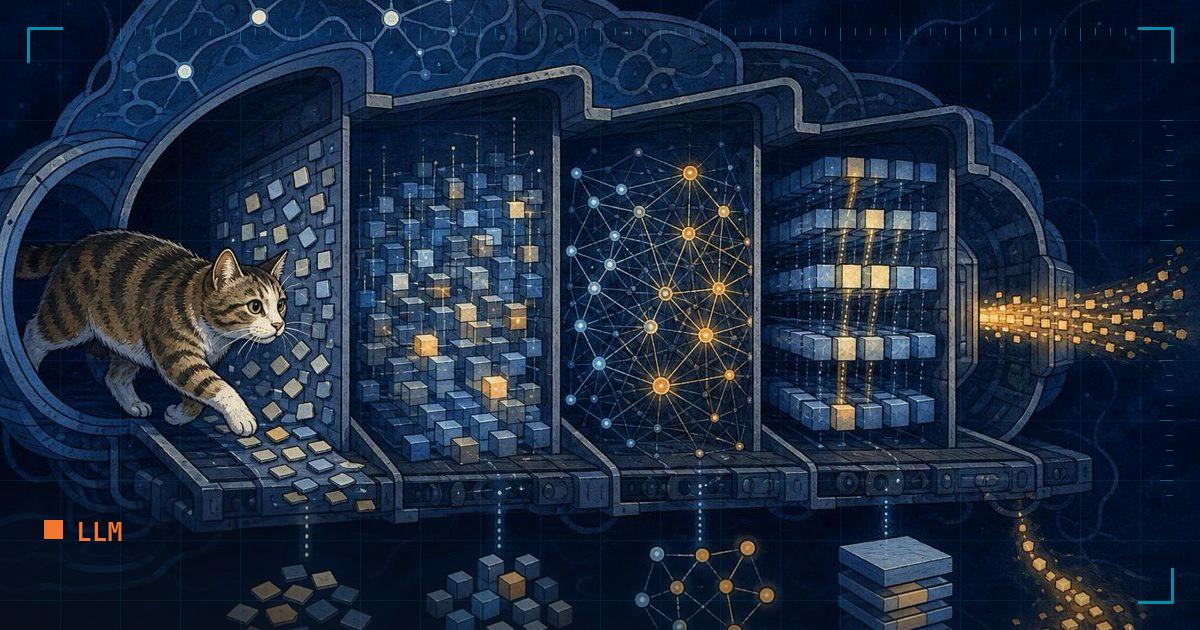
Les LLM restent opaques pour beaucoup de devs. On sait qu’il y a des “transformers” et de l’"attention", mais concrètement ? Flou artistique.
J’ai voulu comprendre ce qui se passe vraiment entre l’entrée d’un prompt et la sortie d’une réponse. Pas les formules mathématiques - juste le mécanisme, étape par étape.
J’ai créé ce guide visuel avec un fil rouge simple : la phrase “Le chat mange” traverse chaque couche du modèle. Du texte brut jusqu’à la prédiction du mot suivant.

Ce que le guide couvre
Le parcours complet d’un token à travers le modèle :
- Tokenization : comment “Le chat mange” devient une séquence de nombres
- Embeddings : transformer ces nombres en vecteurs de sens
- Attention : le mécanisme qui relie les mots entre eux
- Feed-forward : les transformations non-linéaires
- Génération : prédire le mot suivant avec les probabilités
Chaque étape est illustrée avec des schémas et des exemples concrets.
Les optimisations expliquées
Le guide couvre aussi les techniques d’optimisation utilisées en production :
- KV Cache : éviter de recalculer l’attention sur les tokens déjà traités
- Quantization : réduire la précision des poids pour économiser la mémoire (FP16, INT8, INT4)
- MoE (Mixture of Experts) : activer seulement une partie du modèle selon la requête
- Function Calling : connecter le modèle à des outils externes
Pourquoi ce format
J’apprends mieux avec des visuels qu’avec des équations. Ce guide est celui que j’aurais voulu trouver quand j’ai commencé à m’intéresser aux LLM.
Pas de prérequis en machine learning. Si vous savez ce qu’est un vecteur et une matrice, vous pouvez suivre.
Ce que vous devez retenir
- Un LLM transforme d’abord le texte en tokens puis en vecteurs ; le Transformer ne manipule jamais directement des mots.
- L’attention relie chaque token à son contexte, puis les couches feed-forward transforment ces représentations avant la prédiction suivante.
- KV cache, quantization et MoE ne changent pas le principe du modèle : ils réduisent surtout le coût mémoire ou de calcul de l’inférence.
- Garder ce parcours mental - tokens, vecteurs, attention, transformation, logits - suffit à comprendre une grande partie des optimisations modernes.
Sources
- The Illustrated Transformer | Jay Alammar (attention, embeddings, mécanisme)
- The Illustrated GPT-2 | Jay Alammar (génération auto-régressive, tokens)
- Transformer Inference Arithmetic | Kipp (KV cache, memory-bound, batch)
- Mixture of Experts explained | Hugging Face (MoE, routing)
- A Gentle Introduction to 8-bit Matrix Multiplication | Hugging Face (quantization)