Je voulais faire tourner un très gros modèle MoE chez moi, sans changer de cartes graphiques. Deux RTX 3090 de 24 Go étaient disponibles sur mon nœud GPU. Mon enveloppe de mémoire vive était serrée : 64 Go au total sur la machine, loin des 128 ou 256 Go qu’on aimerait consacrer au modèle. Et je tenais à un contexte de 64K, au-delà d’une démo confortable sur 4 096 tokens.
Le résultat a été plus encourageant que prévu : avec Strata, j’ai observé dans les logs environ 100 à 106 tokens/s sur une session de génération. Puis j’ai ouvert deux sessions en parallèle. L’expérience n’avait plus du tout la même allure.
C’est cette différence qui m’intéresse. Faire afficher un gros chiffre de débit sur un modèle local est une chose. En faire un vrai serveur d’inférence pour plusieurs usages en est une autre.
Pourquoi un MoE ne se traite pas comme un modèle dense
Sur un modèle dense, la plupart des poids contribuent à chaque token. Sur un mixture of experts (MoE), un routeur ne sélectionne qu’une partie des experts à chaque passage. La taille totale des poids reste importante, mais le calcul actif par token est bien plus faible.
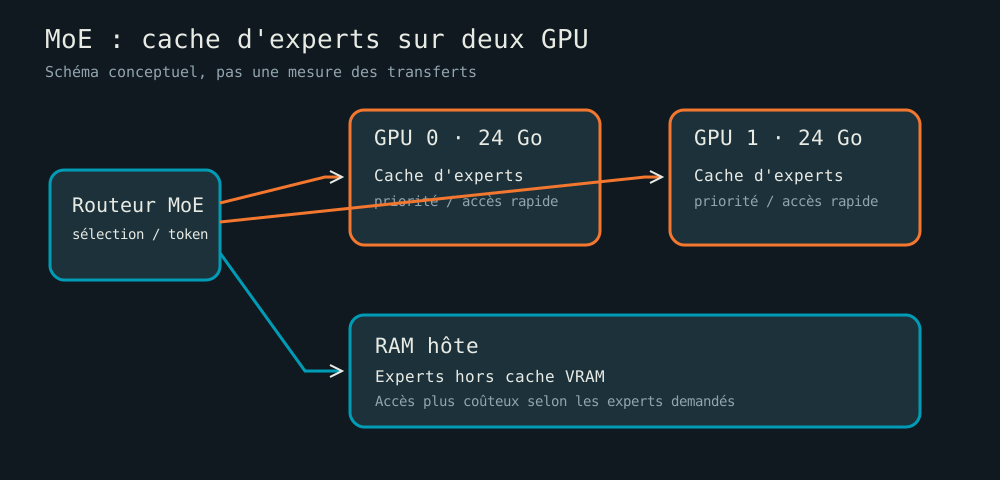
Cela ouvre une possibilité très concrète sur du matériel limité : garder une partie des experts en VRAM et faire intervenir la RAM hôte pour les autres. À condition de ne pas transformer chaque token en une procession d’accès mémoire trop coûteux.
Strata est intéressant précisément sur ce terrain : un moteur d’inférence spécialisé dans l’exécution locale des gros MoE, qui s’appuie sur un cache d’experts et l’organisation du calcul entre CPU et GPU. Les transferts gardent un coût. Le moteur permet malgré tout d’essayer de faire tenir un modèle plus gros que la VRAM disponible avec un débit exploitable.
Le montage : deux GPU, une quantification agressive et un vrai contexte long
La configuration retenue est volontairement pragmatique :
| Élément | Configuration de l’essai |
|---|---|
| GPU | 2 × RTX 3090, 24 Go chacune |
| Mémoire hôte | 64 Go physiques |
| Modèle | Qwen3.8-Flash-Next, GGUF GSQ-RCO IQ3_S d’ISTA-DASLab |
| Moteur | Strata v0.1.39, build CUDA adapté aux 3090 |
| Contexte configuré | 65 536 tokens |
| KV cache | Quantifié 4 bits |
| Mode mémoire | LOW_RAM activé |
| Orchestration | Kubernetes, sur un nœud GPU dédié |
La fiche officielle de Qwen3.8-Flash-Next annonce 125 milliards de paramètres, dont 6 milliards activés par token, auxquels s’ajoutent une table n-gram de 51 milliards de paramètres et un module de prédiction de tokens MTP de 4 milliards. Le petit nombre de paramètres actifs réduit le calcul ; les poids à stocker restent là.
Le checkpoint utilisé est ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF, variante IQ3_S. Sa fiche donne environ 83,6 Go en deux fichiers GGUF : 54,8 Go de poids et 28,8 Go de table n-gram. Ce volume sur disque ne dit rien de la VRAM nécessaire : le placement et les accès aux poids déterminent la mémoire effectivement occupée.
La quantification représente ici un compromis. Cette variante utilise une précision mixte, annoncée à 3,5 bits par poids en moyenne sur les poids du transformer, avec des couches plus ou moins compressées. Je n’avais pas la marge pour une version Q4 confortable.
Le chiffre flatteur : environ 100 tokens/s
Voici l’ordre de grandeur vu dans les logs du moteur :
thinking: 914 of max 1000 tokens, 101.2 tok/s
done: 1000 tokens in 10 s (100.6 tok/s)
expert cache 99.9% hit
Sur une autre séquence, le débit affiché était voisin de 106 tokens/s.
Le 99,9 % de hit rate du cache des experts est intéressant, mais il faut l’interpréter correctement. Un excellent taux de hits ne garantit ni un TTFT court, ni une bonne montée en concurrence, ni une stabilité du débit sur tous les prompts. Il renseigne sur un mécanisme interne du moteur, et sur rien d’autre.
Un autre log était presque plus instructif : la génération atteignait sa limite de 1 000 tokens de réflexion sans laisser de réponse visible. Le moteur avait travaillé vite, mais le client n’avait rien reçu d’utile. Le coupable était le budget de raisonnement.
Optimiser l’inférence implique donc aussi de distinguer tokens de réflexion et tokens visibles, de fixer des budgets cohérents et d’observer ce que reçoit réellement l’application.
Deux sessions changent le diagnostic
Le premier vrai problème est apparu lorsque j’ai lancé un deuxième agent avec un prompt d’environ 23 000 tokens. Pendant le prefill de ce prompt, la génération du premier agent s’effondrait.
| Situation | Débit de génération du premier agent | Hits du cache d’experts |
|---|---|---|
| Session seule | 100 à 106 tokens/s | 99,9 % |
| Pendant le prefill d’un prompt de 23K tokens par un deuxième agent | 18 à 26 tokens/s | 97 à 99 % |
Le cache d’experts restait presque entièrement servi depuis les GPU. Avoir les experts sous la main ne suffit donc pas lorsque le prefill d’un contexte et le décodage d’un autre se disputent les mêmes ressources.
J’ai essayé trois sessions, mais la fluidité n’était pas acceptable pour une utilisation interactive. J’ai finalement retenu parallel: 1 : la deuxième demande patiente au lieu de ralentir celle qui répond déjà. Je privilégie ici la latence ressentie au débit total théorique.
Le cache d’experts est devenu un sujet d’observabilité
Je voulais comprendre quels experts occupaient le cache VRAM, lesquels restaient côté mémoire hôte et comment cette répartition évoluait.
Le endpoint /metrics de Strata v0.1.39 renvoyait du JSON, alors que la collecte attendait du texte Prometheus. Une petite passerelle de conversion m’a permis de suivre les métriques du moteur sans le redémarrer. Le profil appris, sauvegardé périodiquement, sert à visualiser la couverture du cache par couche et les experts bien classés restés hors VRAM.
Ce profil est un classement appris : il aide à comprendre le placement, il ne compte pas chaque routage en temps réel. Pour juger la fluidité des agents, je le rapproche toujours du TTFT et du débit reçu par chaque client.
Passer à 128K et retrouver une conversation sans tout relire
Après les premiers essais à 65 536 tokens, j’ai aligné Strata et ses clients sur 131 072 tokens.
Avec parallel: 1, la question suivante était pratique : lorsque je passe de la conversation A à B, puis que je reviens à A, faut-il relire presque 128K tokens à chaque fois ?
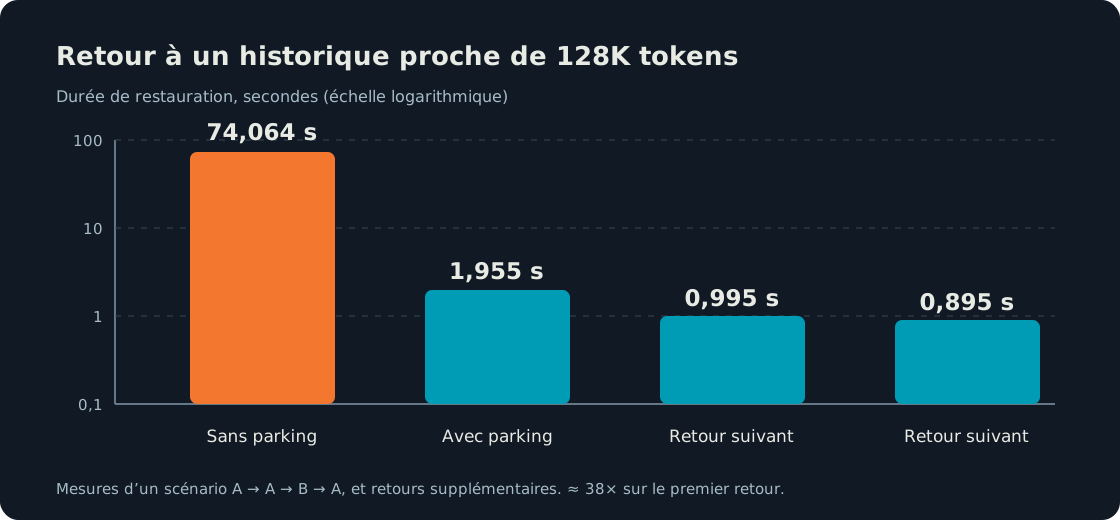
J’ai testé le parking RAM : je garde en RAM l’état de la conversation inactive (son KV cache) pour la reprendre sans recalculer tout son historique. Le protocole alternait A → A → B → A, avec deux historiques de 130 900 à 130 992 tokens.
| Mesure | Résultat |
|---|---|
| Retour à A sans restauration rapide | 74,064 s |
| Retour à A avec parking | 1,955 s |
| Deux retours suivants | 0,995 s et 0,895 s |
| Surcoût de première capture | 2,496 s |
| Événements relevés | 5 parks, 3 restores, aucune éviction |
| Cache RAM en fin de test | 4,904 Gio |
Dans cette séquence, le retour à A est environ 38 fois plus rapide. Le gain porte sur la reprise du contexte ; la génération des nouveaux tokens garde sa vitesse habituelle, et la première lecture reste coûteuse.
J’avais configuré 8 Gio de parking, quatre slots, un seuil de 1 024 tokens et un plancher de 4 Gio disponibles. Le conteneur disposait d’une limite de 50 Gio.
Le 17 octobre, après les essais et un rollback de vérification, la configuration a été déployée via ArgoCD. Les vérifications post-déploiement ont confirmé la restauration proche de 128K ainsi qu’une génération soutenue de plus de 1 024 tokens de sortie pour un contexte de 126 à 127K tokens.
Un dernier piège : les options du moteur sont enregistrées dans un JSON persistant. Revenir au manifeste Kubernetes précédent ne suffit pas à effectuer un rollback complet de ces paramètres.
Les limites de cet essai
Ces chiffres viennent de logs et d’essais en exploitation sur Strata v0.1.39, jusqu’au 17 octobre 2026. Ils ne décrivent pas les versions plus récentes du moteur, et plusieurs points restent à mesurer :
- Qualité. Je n’ai pas encore évalué la quantification IQ3_S sur mes tâches ; un débit ne dit rien de la qualité des réponses.
- Contexte long. 64K puis 128K sont des valeurs de configuration. Le rappel d’informations éloignées à cette profondeur reste à tester.
- Concurrence. Il manque des répétitions contrôlées, un suivi du TTFT et un débit agrégé à charge identique, ainsi qu’une comparaison contre vLLM ou SGLang.
- Parking. Les tests ne prouvent pas que quatre conversations remplies à 128K tiennent simultanément en cache.
- Production. Trois réserves demeurent : stabilité des préfixes réels d’OpenCode, ralentissements intermittents en décodage et marge mémoire à froid.
Une troisième RTX 3090 existe sur la machine, mais elle sert à d’autres workloads. Lui emprunter 10 Go de VRAM pour Strata est une piste ; avant de compliquer l’architecture, je préfère une baseline fiable sur deux cartes.
Ce que vous devez retenir
- Mesurer ce que voit l’utilisateur. Les 100 à 106 tokens/s en solo cachent une chute à 18 à 26 tokens/s quand un autre agent commence un long prefill.
- Choisir le parallélisme selon l’usage. Pour mes agents interactifs, une file d’attente avec
parallel: 1est plus agréable qu’une concurrence qui ralentit tout le monde. - Distinguer reprise et génération. Le parking fait passer un retour à un historique proche de 128K de 74 s à environ 2 s dans mon essai, sans toucher au débit de décodage.
- Conserver des marges et un rollback réel. Le budget RAM, les préfixes instables et la configuration persistante restent déterminants en production.