Je veux que mon agent me réponde à la voix, en local, sans rien envoyer dehors. Le TTS tourne sur l’iGPU Radeon 780M d’un mini-PC : Qwen3-TTS servi par qwentts.cpp, talker 1.7B quantisé en Q8. En août, j’avais choisi une voix à l’oreille et noté un RTF de 1,25. Ça semblait acceptable.
Ça ne l’est pas. Un RTF supérieur à 1 interdit la conversation, et pas un peu.
Pourquoi 1,25 est un mur et pas un inconfort
Le RTF est le temps de calcul divisé par la durée de l’audio produit. À 1,25, le serveur produit 0,8 seconde de parole par seconde de travail, alors que la lecture en consomme 1. Le déficit est de 0,2 seconde par seconde.
Pour lire D secondes sans trou, il faut donc avoir mis 0,22 x D secondes en tampon avant de commencer. Pour une réponse de vingt secondes, ça fait plus de quatre secondes de tampon, soit près de six secondes d’attente avant le premier son. Aucune découpe en phrases ne contourne ça : c’est de l’arithmétique, pas de l’ingénierie.
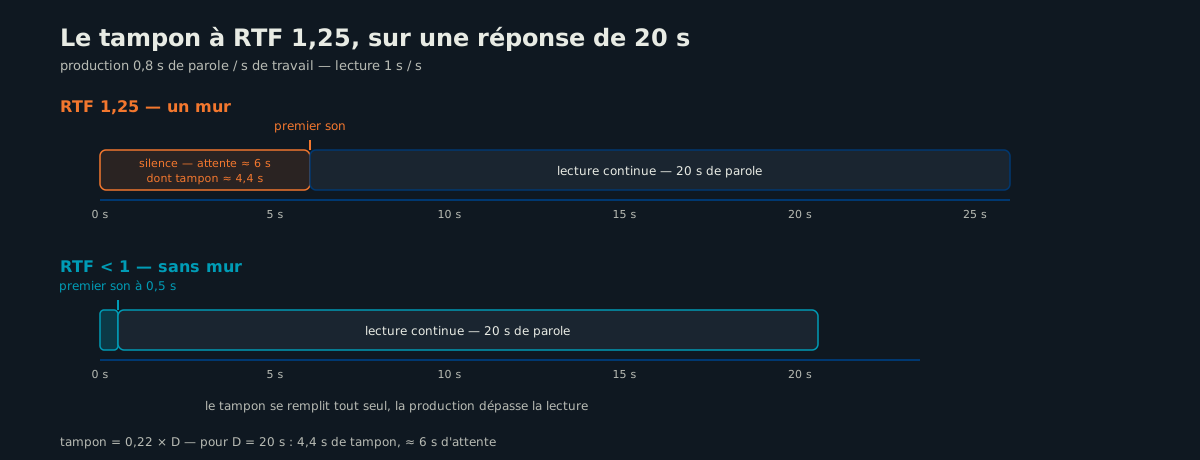
Sous 1, le problème disparaît entièrement. La production dépasse la lecture, le tampon se remplit tout seul, on démarre en une demi-seconde. Tout l’enjeu tient donc à franchir cette barre.
Le RTF est un rapport, donc il flatte
Première mesure sur le talker quantisé en Q4 : RTF 0,81. Sauf que l’audio produit pour la même phrase durait 10,2 secondes au lieu de 6,9.
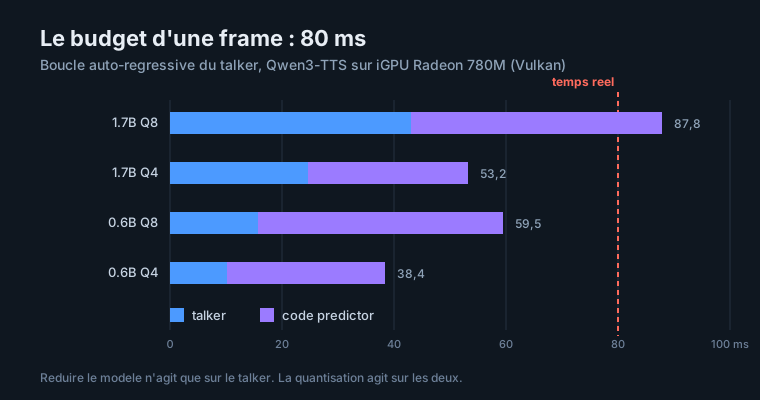
Le RTF a un dénominateur. Un modèle qui parle plus lentement, ou qui ajoute du silence, améliore son RTF sans avoir accéléré d’un cycle. Le chiffre qui ne triche pas, c’est le temps par frame de la boucle auto-régressive : à 12,5 Hz, chaque frame dispose de 80 ms. Le serveur le publie dans ses logs, il suffit de le lire.
| Modèle | Boucle AR | RTF |
|---|---|---|
| 1.7B Q8 | 87,8 ms/frame | 1,245 |
| 1.7B Q4 | 53,2 ms/frame | 0,814 |
Les 39 % de gain sur la boucle sont réels. Le RTF, lui, mélange l’accélération et le changement de débit de parole. J’ai gardé les deux colonnes dans toutes mes mesures depuis.
Deux moitiés, deux leviers, et une surprise
Le serveur décompose son travail. Sur le talker 1.7B Q8, chaque frame coûte 43 ms de décodage du talker et 45 ms de code predictor, ce dernier enchaînant quinze passes séquentielles pour les codebooks résiduels.
J’ai donc testé les deux leviers séparément, une variable à la fois.
| Modèle | Talker (ms/frame) | Code predictor (ms/frame) | Boucle AR (ms/frame) | RTF |
|---|---|---|---|---|
| 1.7B Q8 | 43,0 | 44,8 | 87,8 | 1,245 |
| 1.7B Q4_K_M | 24,6 | 28,6 | 53,2 | 0,814 |
| 0.6B Q8 | 15,7 | 43,8 | 59,5 | 0,880 |
| 0.6B Q4_K_M | 10,2 | 28,2 | 38,4 | 0,617 |
Réduire le modèle de 1,7 à 0,6 milliard de paramètres divise le talker par 2,7 et ne touche pas au code predictor. La quantisation, elle, agit sur les deux. Les deux effets se cumulent sans interaction : j’avais prédit 38 ms pour la dernière ligne, j’ai mesuré 38,4.
D’où le résultat que je n’attendais pas : le gros modèle quantisé va plus vite que le petit modèle en Q8. Diviser le modèle par trois fait perdre en qualité pour aller moins vite qu’une simple requantisation. Si je n’avais testé que la taille, comme je comptais le faire au départ, j’aurais pris la mauvaise décision en croyant l’avoir mesurée.
Trois pièges de mesure
Le premier appel après un redémarrage du pod coûte une seconde et demie de plus, le temps de recompiler les shaders mesa. Ma première mesure annonçait 1,29 au lieu de 1,24. Toutes les suivantes sont prises à chaud.
Le format de sortie change le résultat. En wav, le serveur décode le codec par fenêtres ; en pcm, il maintient un état continu. Le même texte coûte 96,9 ms par frame dans le premier cas contre 87,6 dans le second, soit 11 % d’écart pour un choix qui semble cosmétique.
Et kubectl logs --since ne rend qu’une ligne là où --tail en rend douze sur ce conteneur. J’ai cru pendant dix minutes que le serveur ne journalisait plus.
Mesurer une voix sans l’écouter
Une fois le mur du temps réel franchi, la vraie question est devenue la qualité. Or j’écoute mal : au bout de vingt échantillons, je ne sais plus si la voix a changé ou si c’est moi.
Trois grandeurs se calculent sur un WAV avec numpy et rien d’autre. La hauteur fondamentale par autocorrélation, sa dispersion à l’intérieur d’une phrase, et la fraction de trames dont la hauteur se situe autour du double de la médiane. Ce dernier chiffre attrape les sauts d’octave, ce qui s’entend comme une voix qui casse.
| Échantillon | F0 médiane | Écart interquartile | Sauts d’octave |
|---|---|---|---|
| 1.7B Q8, la voix retenue en août | 158 Hz | 62 Hz | 14,3 % |
| 1.7B Q4 | 130 Hz | 106 Hz | 14,0 % |
| 0.6B Q8 | 140 Hz | 55 Hz | 1,3 % |
Sur une voix humaine stable, l’écart interquartile tourne autour de 20 à 40 Hz. Toutes mes valeurs sont hautes, y compris celle de la voix que j’avais validée en août à l’oreille. L’instabilité était donc là depuis le début et je ne l’avais pas entendue. La quantisation aggrave l’étalement, elle ne l’a pas créé.
Le détecteur pouvait se tromper d’octave, c’est le défaut classique de l’autocorrélation. J’ai vérifié sur les histogrammes : le même détecteur, sur le même texte et le même seed, trouve 14 % de trames au double sur une variante et 1,3 % sur l’autre. Un biais de mesure aurait touché les deux.
Restait à vérifier que ces chiffres correspondent à quelque chose qu’on entend. Ils ne correspondaient à rien.
La fausse piste du sampling
Le serveur applique par défaut une température de 0,9, un top-k de 50 et une pénalité de répétition de 1,05. Pour de la synthèse vocale, 0,9 est haut. L’hypothèse tenait debout : trop d’aléa, donc une identité vocale qui dérive d’une génération à l’autre. Et ces valeurs se règlent par requête, donc sans rien redéployer.
Premier balayage, quatre seeds, un texte : à température 0,3, la dispersion entre générations est divisée par trois. J’ai failli livrer le correctif.
Deuxième balayage, deux textes : la conclusion s’effondre. Sur un texte plus difficile, baisser la température double l’écart interquartile au lieu de le réduire. Le premier résultat était du bruit, obtenu sur un échantillon trop mince.
Pire, un des échantillons à basse température durait 163,84 secondes. Ce nombre n’a rien d’aléatoire : c’est 2048 frames à 12,5 Hz, soit le plafond de jetons du serveur. Le modèle n’a jamais émis sa fin. Il a dit le texte à une lenteur invraisemblable sur cent secondes, puis produit du quasi-silence jusqu’à la butée. Whisper, à qui j’ai donné cet extrait, y a halluciné une adresse de site web, ce qu’il fait volontiers sur du silence.
C’est le mode d’échec classique du sampling à basse température : sans assez d’aléa, le modèle boucle et ne trouve plus son jeton de fin. Monter la pénalité de répétition à 1,15 le supprime complètement. Mais aucune combinaison de température et de pénalité n’a amélioré la stabilité de la hauteur.
Le phénomène dépend du texte, et c’est ce qui le rend méchant : sur ma phrase de test, tout allait bien. En production, une réponse sur dix aurait bloqué le GPU cent secondes pour produire de l’inécoutable.
Le test en aveugle, et la métrique qui tombe
En générant la même phrase avec des seeds différents, j’obtiens tout et son contraire : une version à 34 Hz de dispersion et 0,3 % de sauts d’octave, la suivante à 247 Hz et 21,8 %. La qualité est une loterie par génération, pas une propriété du modèle. Ça change la stratégie : plutôt que de chercher le réglage parfait, on peut détecter les ratés et les rejouer.
Encore faut-il que la détection marche. J’ai donc pris quatre générations, deux que ma note jugeait bonnes et deux mauvaises, je les ai renommées a, b, c, d et je les ai fait écouter sans dire lesquelles étaient lesquelles.
Les deux retenues à l’oreille sont une de mes bonnes, et la pire du lot sur dix générations. Sur un choix de deux parmi quatre, c’est le score du hasard.
En cherchant ce qui séparait vraiment les préférées des rejetées, quatre mesures ressortent, et elles disent toutes la même chose : part du signal réellement voisée, centroïde spectral, énergie au-dessus de 4 kHz, jitter. Autrement dit, la proportion de voix périodique propre face au bruit et à la rugosité. Ma mesure de dispersion de hauteur, elle, ne sépare rien.
L’erreur de conception saute aux yeux après coup. La variation de hauteur à l’intérieur d’une phrase, c’est de la prosodie. En la notant comme un défaut, je récompensais une voix plate. Ce qui dérivait vraiment, c’était l’identité de la voix d’une génération à l’autre, ce qui est une autre grandeur, mesurée autrement.
Quatre échantillons répartis deux contre deux, avec des mesures corrélées entre elles : c’est une hypothèse, pas un résultat. Mais c’est une hypothèse qui a le mérite de contredire la précédente pour de bonnes raisons.
Ce qu’aucun paramètre ne rattrape
La remarque qui a clos la journée : comparé aux modes vocaux d’OpenAI, ça reste une lecture. Là-bas, la voix rit, soupire, porte une émotion.
Ce n’est pas une question de calibration. Ces systèmes sont speech-to-speech : le modèle de langue produit directement les jetons audio, donc il décide de rire en même temps qu’il décide de ce qu’il raconte. Une chaîne LLM puis texte puis TTS perd l’intention en route. Quand mon TTS reçoit “les deux autres sauvegardes sont bonnes”, il n’a aucun moyen de savoir si la phrase est rassurante ou ironique. Aucun réglage ne restaure une information absente de l’entrée.
Il reste des leviers dans cette architecture. Qwen3-TTS propose une variante pilotée par instructions en langage naturel, qui porte sur le timbre, l’émotion et la prosodie, et le client pourrait choisir le ton phrase par phrase. Une référence de clonage enregistrée avec le sourire transfère une partie de sa couleur. Mais l’écart de nature reste, et il vaut mieux le dire avant de passer un mois à régler des paramètres.
Ce que je retiens pour la prochaine calibration
Mesurer le coût par unité de travail, pas le rapport. Un ratio dont le dénominateur est produit par le modèle testé se laisse manipuler par le modèle testé.
Tester chaque levier séparément même quand on croit connaître leur hiérarchie. Deux heures de mesure m’ont évité de diviser mon modèle par trois pour aller moins vite.
Deux échantillons ne font pas une tendance, et un seul texte encore moins. Mes trois erreurs de la journée viennent toutes de là.
Valider une mesure automatique contre une oreille avant de construire dessus. J’avais un score, un classement, et un plan pour rejouer les mauvaises générations. Un test en aveugle de quatre fichiers a suffi à tout défaire, et il aurait coûté moins cher au début qu’à la fin.
Borner le nombre de jetons côté client. Ça ne corrige pas l’emballement, mais ça transforme une panne de cent secondes en troncature d’une phrase. Une durée qui atteint pile le plafond devient au passage un signal d’alerte gratuit.
La suite pour moi tient en deux essais : refaire la comparaison entre variantes sur les mesures qui ont survécu au test en aveugle, et ancrer l’identité vocale dans un enregistrement de référence plutôt que de la laisser se ré-inventer à chaque phrase.
Ce que vous devez retenir
- Ne choisissez pas un TTS sur le seul RTF : il faut aussi regarder le coût réel par étape.
- Testez séparément taille de modèle, quantization, format de sortie et paramètres de génération.
- Une métrique automatique de qualité vocale doit être confrontée à des écoutes en aveugle avant de guider une décision.
- Un seul texte ou quelques échantillons peuvent donner une tendance trompeuse.