Calibrer un TTS local : ce que le RTF ne dit pas
Passer un Qwen3-TTS sous le temps réel sur un iGPU AMD, et découvrir en route que le RTF est un rapport qui flatte, que réduire le modèle n'est pas le meilleur levier, et que baisser la température casse la génération.
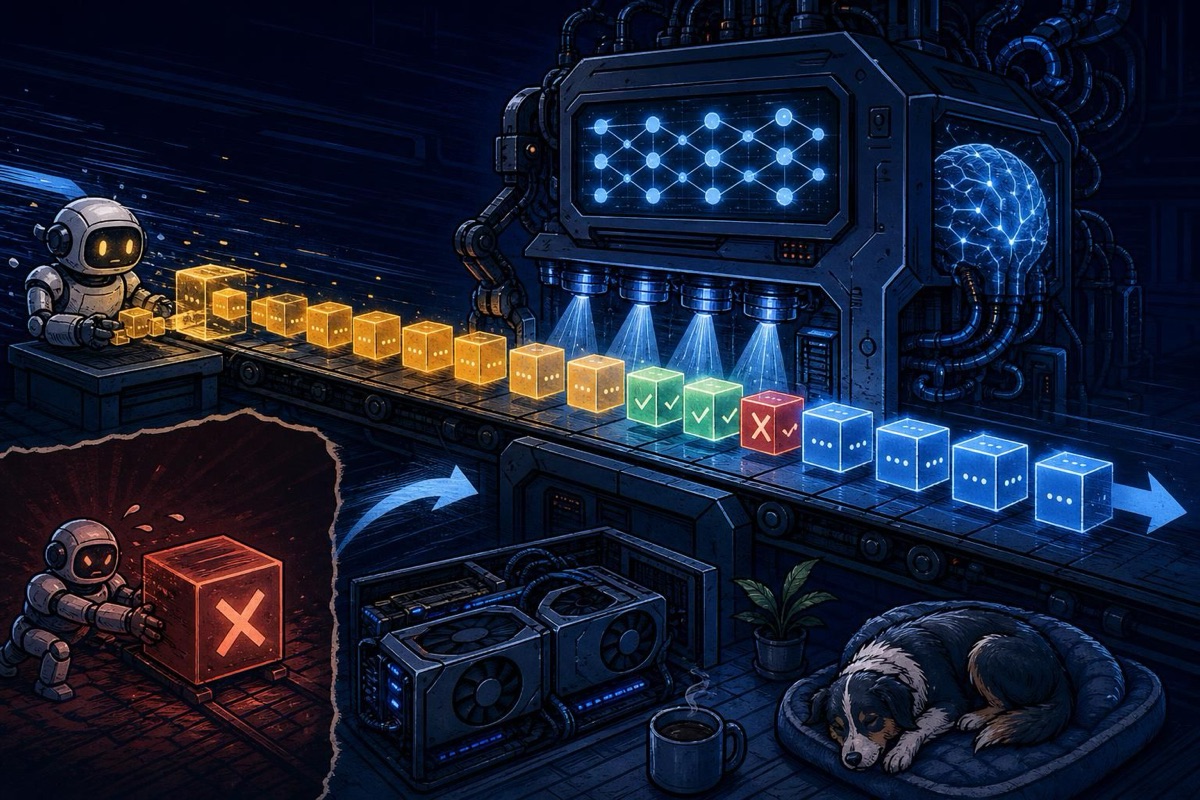
DSpark : prédire plusieurs tokens d'avance avec un draft model pour accélérer le decoding
Un draft model prédit plusieurs tokens à l'avance, le gros modèle les vérifie d'un coup. Comment DSpark corrige les défauts des approches existantes, et ce que trois méthodes donnent réellement sur deux RTX 3090 : le drafter dédié perd, la méthode sans modèle gagne.