Après le silicium : pourquoi le disulfure de molybdène pourrait prendre sa place
L'IMEC prévoit que le canal des transistors passera du silicium à un semi-conducteur 2D vers 2041. Le candidat en tête : le disulfure de molybdène (MoS₂), trois atomes d'épaisseur. J'ai vérifié où en est vraiment la recherche et l'industrie.
Calibrer un TTS local : ce que le RTF ne dit pas
Passer un Qwen3-TTS sous le temps réel sur un iGPU AMD, et découvrir en route que le RTF est un rapport qui flatte, que réduire le modèle n'est pas le meilleur levier, et que baisser la température casse la génération.
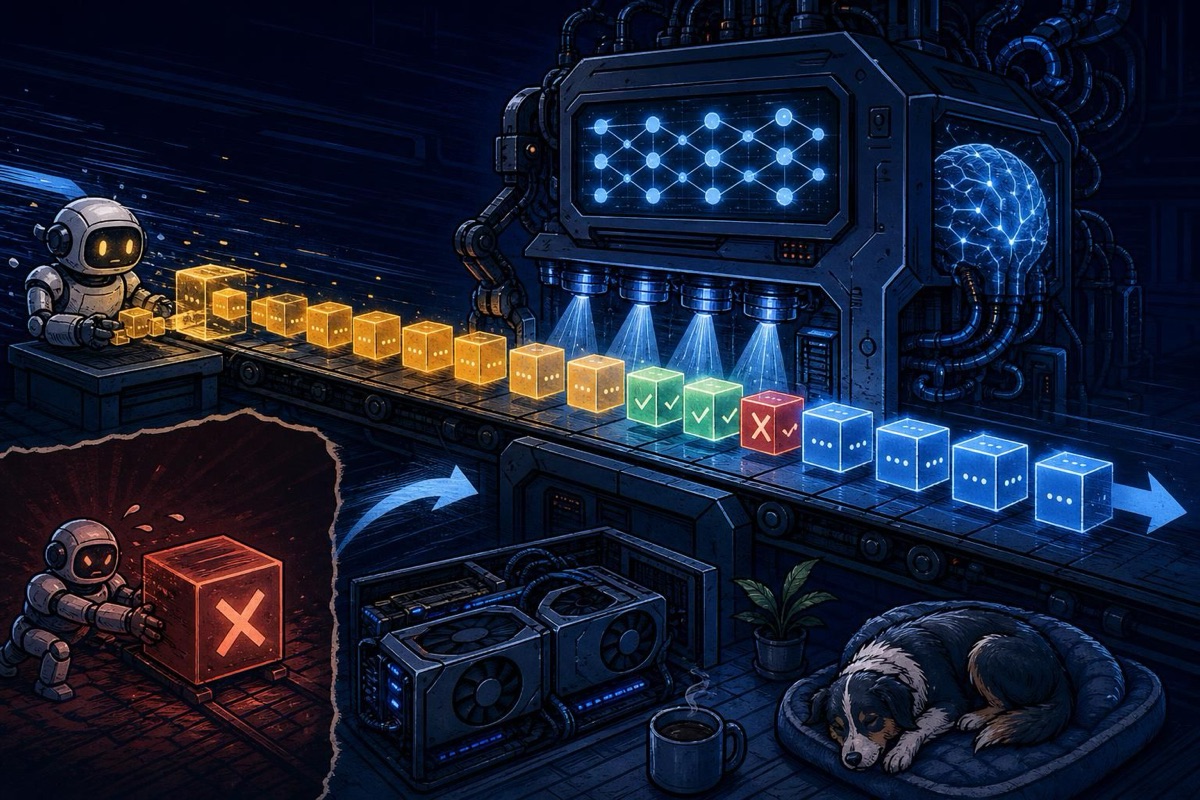
DSpark : prédire plusieurs tokens d'avance avec un draft model pour accélérer le decoding
Un draft model prédit plusieurs tokens à l'avance, le gros modèle les vérifie d'un coup. Comment DSpark corrige les défauts des approches existantes, et ce que trois méthodes donnent réellement sur deux RTX 3090 : le drafter dédié perd, la méthode sans modèle gagne.
Migrer ses secrets Kubernetes de Pulumi ESC vers SOPS + age
Retour d'expérience sur la migration d'un gestionnaire de secrets SaaS vers du chiffrement Git-natif avec SOPS et age, intégré à ArgoCD via un Config Management Plugin.
De vLLM à llama.cpp : servir un LLM sur une seule GPU
Retour d'expérience sur la migration de KServe/vLLM vers llama.cpp pour servir GLM-4.7-Flash sur une RTX 3090, avec n-gram speculative decoding.