Glossaire
Les termes techniques utilisés dans les articles, définis en clair avec une référence pour aller plus loin.
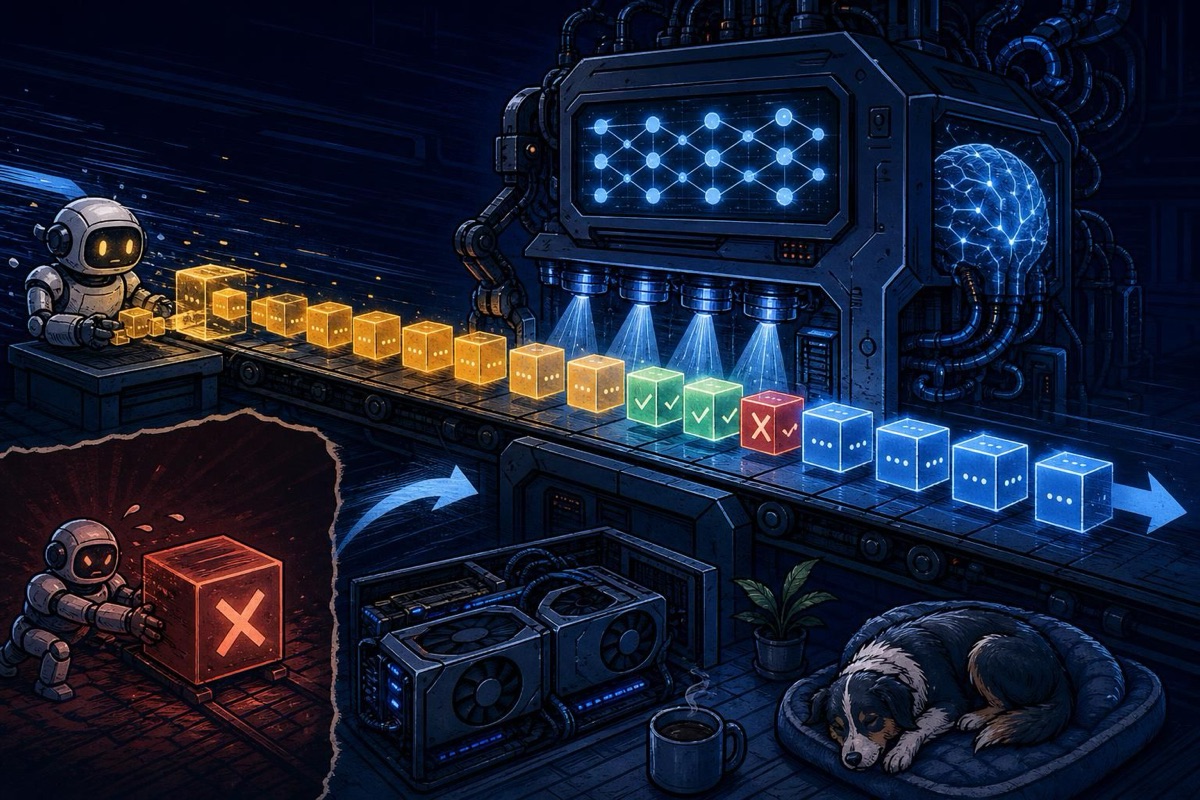
DSpark : prédire plusieurs tokens d'avance avec un draft model pour accélérer le decoding
Un draft model prédit plusieurs tokens à l'avance, le gros modèle les vérifie d'un coup. Comment DSpark corrige les défauts des approches existantes, et ce que trois méthodes donnent réellement sur deux RTX 3090 : le drafter dédié perd, la méthode sans modèle gagne.
De vLLM à llama.cpp : servir un LLM sur une seule GPU
Retour d'expérience sur la migration de KServe/vLLM vers llama.cpp pour servir GLM-4.7-Flash sur une RTX 3090, avec n-gram speculative decoding.
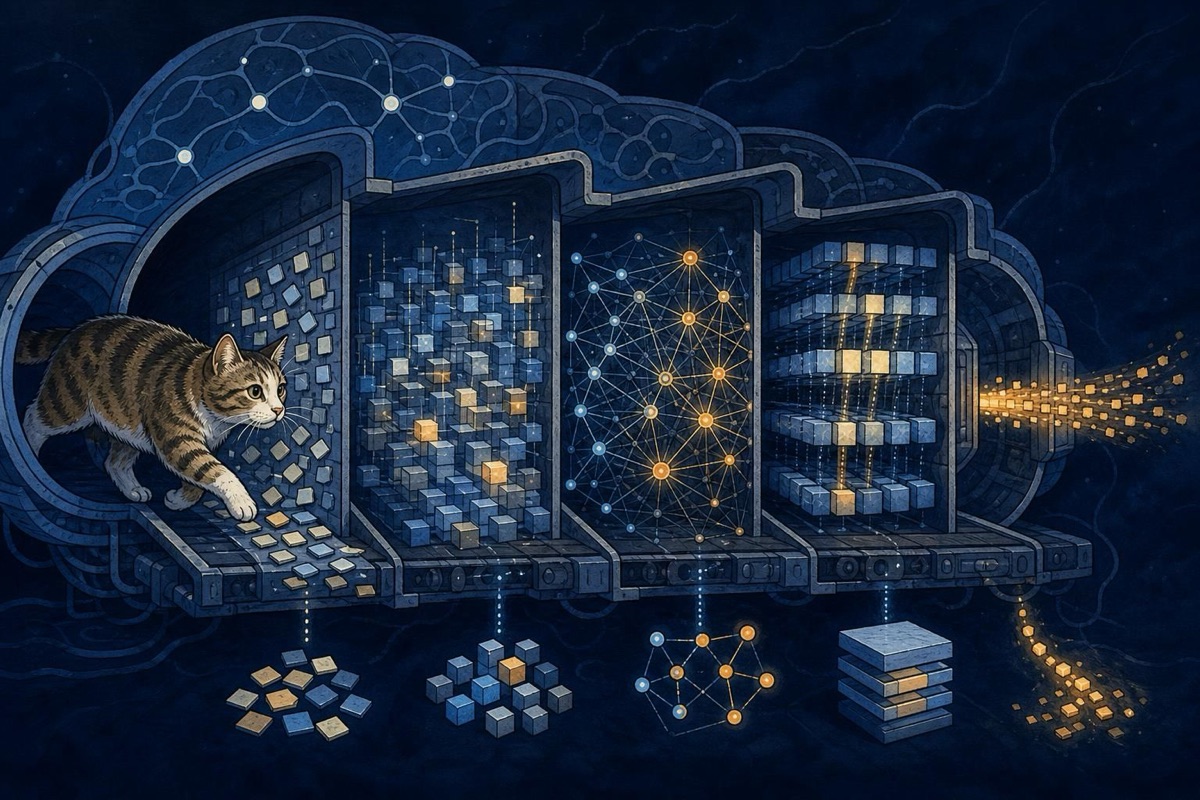
Anatomie d'un LLM
Suivez 'Le chat mange' à travers chaque couche du modèle : tokenization, embeddings, attention, jusqu'à la génération.